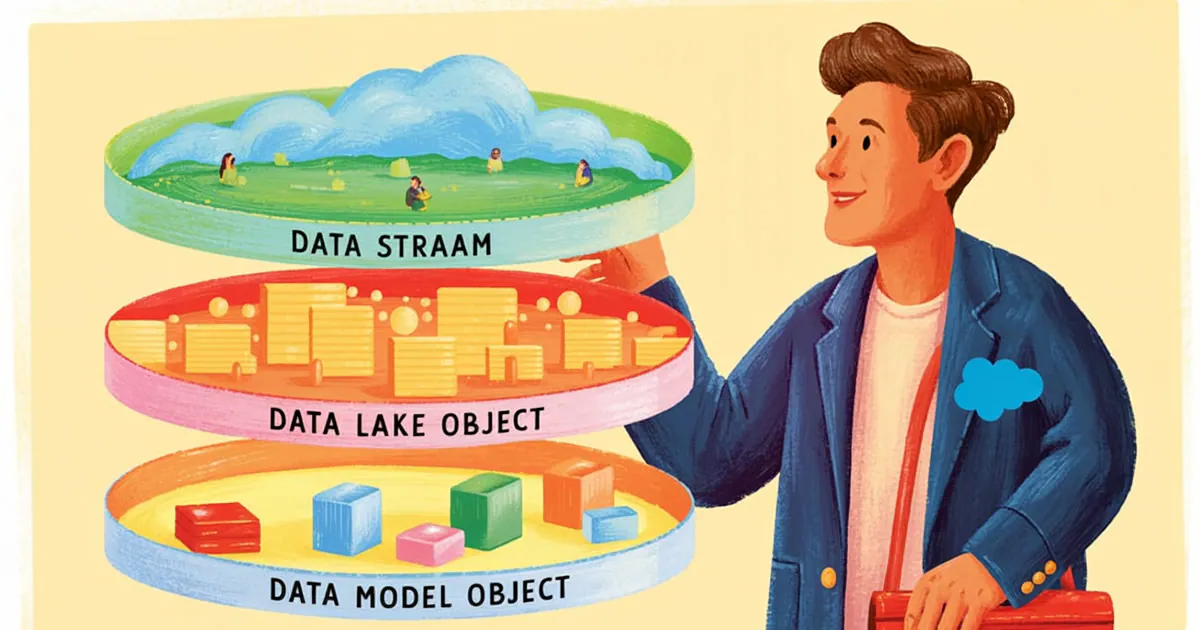
El 5 de febrero, Vantegrate grabó una masterclass de los jueves con un producto que cambia de nombre casi tanto como Experience. Data 360 (antes Data Cloud) no es "otro conector": es la capa que junta silos, armoniza personas y alimenta a Agentforce.
La clase completa está en YouTube. Juan Manuel Garrido (JuanMa) la condujo con Francisco Morales (Fran), Josué Mendoza (Josu) y Esteban Morales (Esti) encima del mapa conceptual (y un poco de pantallas).
El equipo de Vantegrate lo dejó claro de entrada. Van a entender qué goma es Data 360, para qué sirve, cómo se preciosifica y qué significan Data Stream, Data Lake Object y Data Model Object.
La promesa de Fran fue conceptual, no de clic a clic eterno. Si entienden el nombre de cada herramienta de la caja, configurarla después es un camino mucho más corto.
El problema que Data 360 viene a resolver
Fran arrancó con el pitch de Salesforce (y lo marcó como tal). En el segmento enterprise hay cientos de aplicaciones desconectadas entre sí.
Eso se traduce en silos de datos. Tienen información útil para un caso puntual, pero no la pueden cruzar con el resto de la empresa.
JuanMa y Fran abrieron el debate que más duele. El front-end se arma en minutos; lo crítico es dónde vive la información y qué tan organizada está.
Con agentes de IA pasa lo mismo. Montar el agente es relativamente rápido; el diferencial es el contexto correcto en el momento correcto.
Ahí Salesforce juega con ventaja. Si ustedes ya viven en el CRM de Salesforce, Data 360 no es un data lake suelto: es infraestructura pensada para el ecosistema.
Fran lo comparó con productos tipo AWS o Google Cloud. Guardan volumen, sí, pero acá el plus es estar enchufado a Flow, al registro del cliente y a Agentforce sin armar el puente a mano cada vez.
Una historia de nombres (sin el quilombo del calendario)
JuanMa contó la línea de tiempo como quien la vivió de cerca. Hace casi una década Salesforce compra Krux, una pieza muy orientada a interpretar datos de campañas publicitarias.
Después el foco se abre. Aparece Customer 360 como CDP: una plataforma de data de clientes para unificar humanos cuando la empresa no es 100% Salesforce de punta a punta.
En la práctica casi nadie lo es. Tienen Salesforce, y además SAP, Oracle, cobros, e-commerce o comunidades en otras tecnologías.
Vinieron más rebrandings. Salesforce CDP, después Genie, después Data Cloud y, por último, Data 360.
Fran lo dijo sin drama. Posiblemente terminen la masterclass y el producto ya se llame de otra manera; el contenido tiene que referirse al producto, no al sticker de la semana.
JuanMa compartió una anécdota interna de empleados de Salesforce. Los cambios de nombre son tantos que adentro tienen un documento de mapeo para saber qué compró cada cliente.
Su hipótesis (marcada como opinión) es de mercado. Una empresa pública genera hype con nombres nuevos; para el profesional del día a día, a veces queda desorientación.
Josu tiró desde el chat una teoría simpática. El nombre no vende, por eso sigue mutando; el equipo lo tomó con humor y siguió al bloque útil.
Qué es Data 360 (más allá del rebranding)
Fran bajó la definición operativa. Data 360 es una súper base de datos que integra las fuentes que ustedes le quieran conectar y las procesa hacia una base canónica que el CRM (y Agentforce) puedan entender.
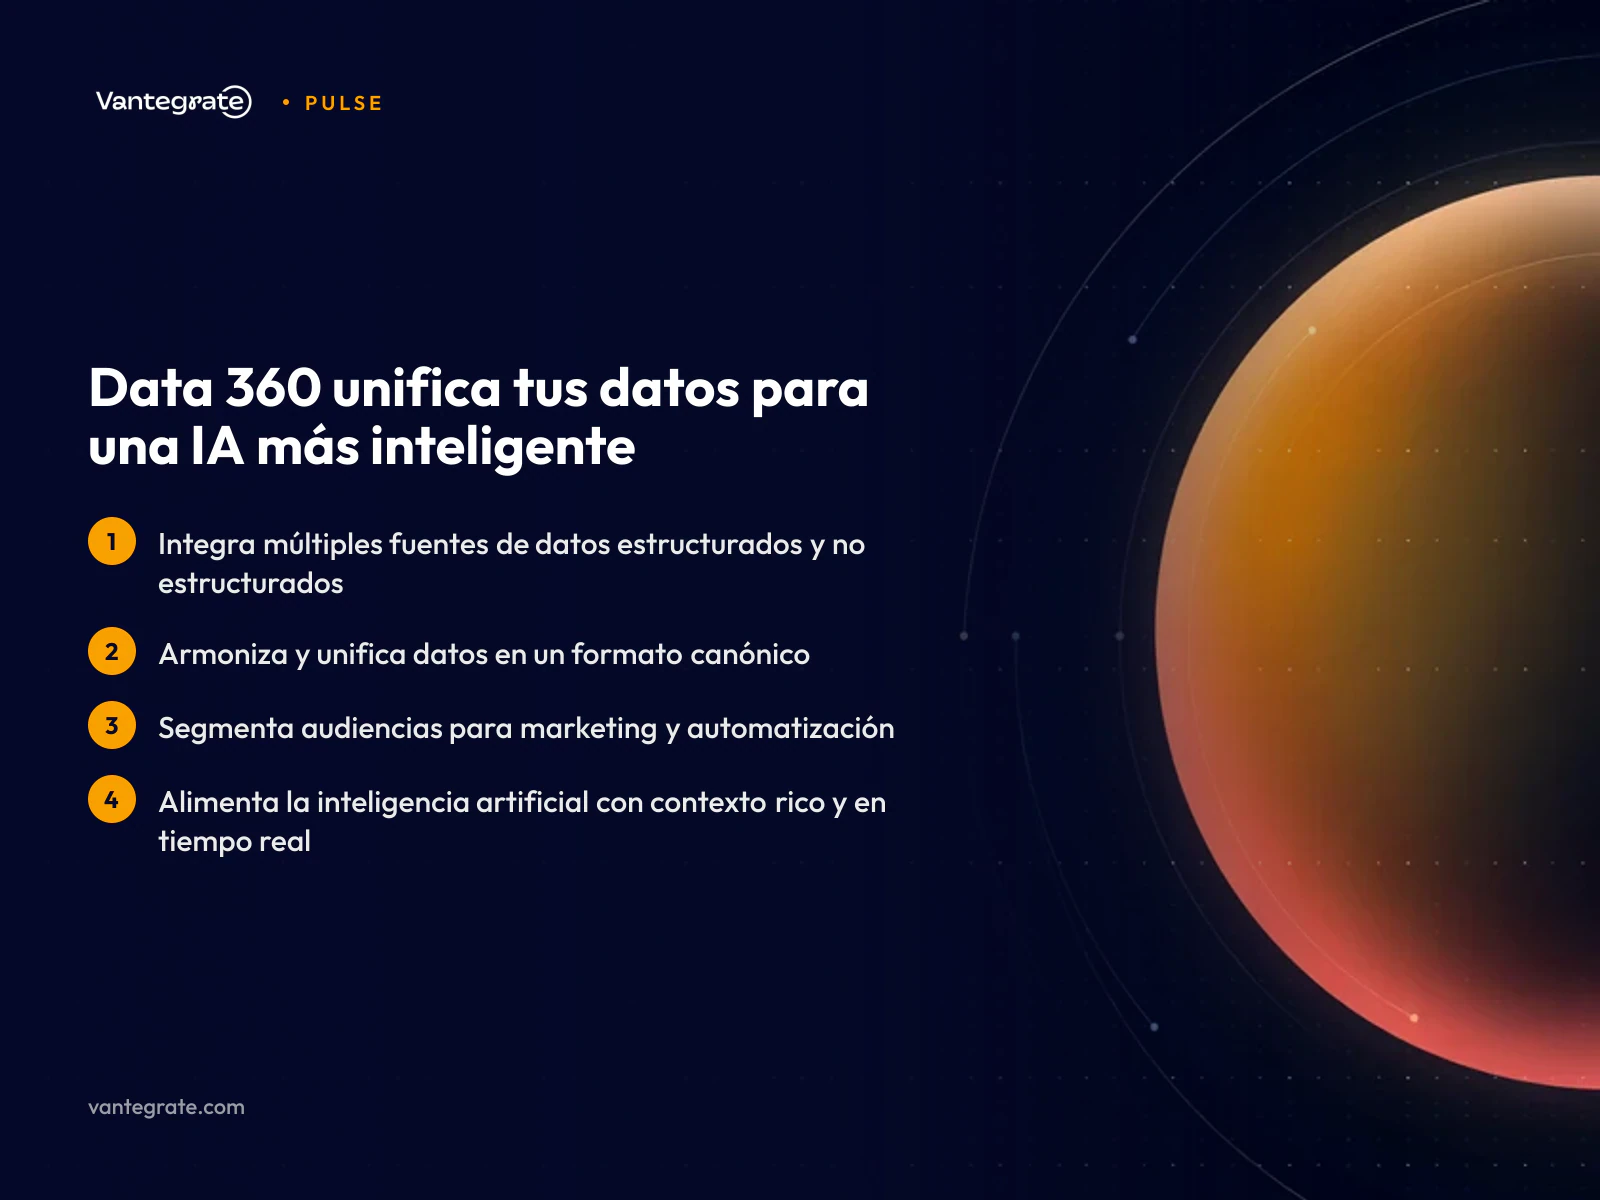
Data 360 es una super base de datos que integra, armoniza y unifica datos de diversas fuentes, preparándolos para CRM e inteligencia artificial.
Primera característica: ingesta multifuente. Estructurada y no estructurada; conectores, archivos, bases no relacionales, lo que haga falta.
Segunda: armoniza y unifica. No deja los datos crudos tirados: los lleva a un formato canónico.
Tercera: segmenta. Si unifican e-commerce con CRM, pueden armar un segmento tipo "compraron ojotas en Jujuy" y disparar marketing o un flujo con Agentforce.
Cuarta: alimenta la IA. Cuanto más contexto tenga el agente en el momento correcto, mejor responde.
Hay capacidad de volumen de otra liga. Fran habló de procesamiento masivo en tiempo real; por eso no alcanza con "unos conectores y listo".
También compite en la conversación de data lake houses. BigQuery, Databricks, Redshift existen; la ventaja de Data 360 es que ya está integrado al ecosistema Salesforce.
Del chat preguntaron si pelea contra Snowflake. La respuesta de la clase fue de integración: pueden conectar Snowflake (u otro lake) y usarlo dentro del flujo Salesforce, no pelearse a muerte.
Cero copy: ingerir sin guardar (cuando aplica)
Del chat llegó una pregunta picante. ¿Cuál es la diferencia entre ingesta y almacenamiento?
Fran usó analogía de comida. Ingerir es masticar y usar; almacenar es procesar y guardar en una base.
Data 360 tiene cero copy: puede consumir información de otro sistema sin copiarla a su storage. No es "nunca guarda nada"; es una modalidad poderosa cuando no quieren duplicar el lago entero.
Pricing: Foundations, créditos, storage y add-ons
JuanMa (self-proclaimed master of the pricing) mostró una versión simplificada del esquema. Aclaró que en la vida real es todavía más complejo.
Si tienen edición Enterprise, Salesforce Foundations puede dar acceso a Data 360 sin comprar el producto "suelto". No es infinito: después aparecen créditos, storage y add-ons.
Los créditos viven en un wallet (billetera). Sirven para procesar datos, ejecutar jobs y operar funcionalidades.
El storage en Data 360 es otro mundo frente a archivos en Core: tiene su propio precio, que se negocia con el Account Executive.
También repasaron el precio por perfiles: en el listado oficial de Salesforce, el plan Profiles cuesta 240 dólares cada 1.000 perfiles por año (región y contrato pueden moverlo).
Hay categorías de consumo. Conectar y armonizar (por millón de filas), procesamiento en tiempo real (por millón de eventos o API), inferencias (analizar y predecir) y procesamiento batch.
Fran sumó la novedad de simplificación. Antes había varios tipos de crédito; ahora tienden a unificar y muestran consumo en una digital wallet al estilo de las APIs de OpenAI.
Sobre Foundations, remiten a clases grabadas previas. Josu, Esti y Fran ya mostraron la activación; acá no rehicieron el wizard completo.
Sobre precios de producto y demos de arquitectura, el consejo de la clase fue pedir el detalle en comunidad y mirar Foundations antes de asustarse con el brochure.
Casos de uso: del perfil 360 al churn
El perfil unificado 360 es el mismo sueño del CRM, pero con mucha más información de afuera: e-commerce, otro marketing, touchpoints de redes o web.
Personalización en tiempo real es el ejemplo de las ojotas. Segmentan, activan y mandan la promo al público correcto.
Lead scoring más preciso. Si miden interacción sin declaración explícita de compra, pueden priorizar mejor.
Prevención de churn. Detectar señales de baja antes de que el cliente se vaya.
Fran también pasó compliance y gobernanza "de corrido". En proyectos serios, seguridad y transparencia de datos no son el capítulo opcional del final.
La arquitectura de alto nivel que dibujaron es simple de recordar. Conectar → armonizar y unificar → analizar y actuar.
Piensen el medio como un ETL con alma de cliente. Correo en el e-commerce, username en otra app, nombre en marketing: el proceso tiene que decir "esto es la misma persona".
Conceptos que tienen que resonar: Stream, Lake y Model
Fran dijo el objetivo de la masterclass sin vueltas. Que se vayan sabiendo qué es un DMO, un DLO y un Data Stream, aunque después investiguen el detalle.
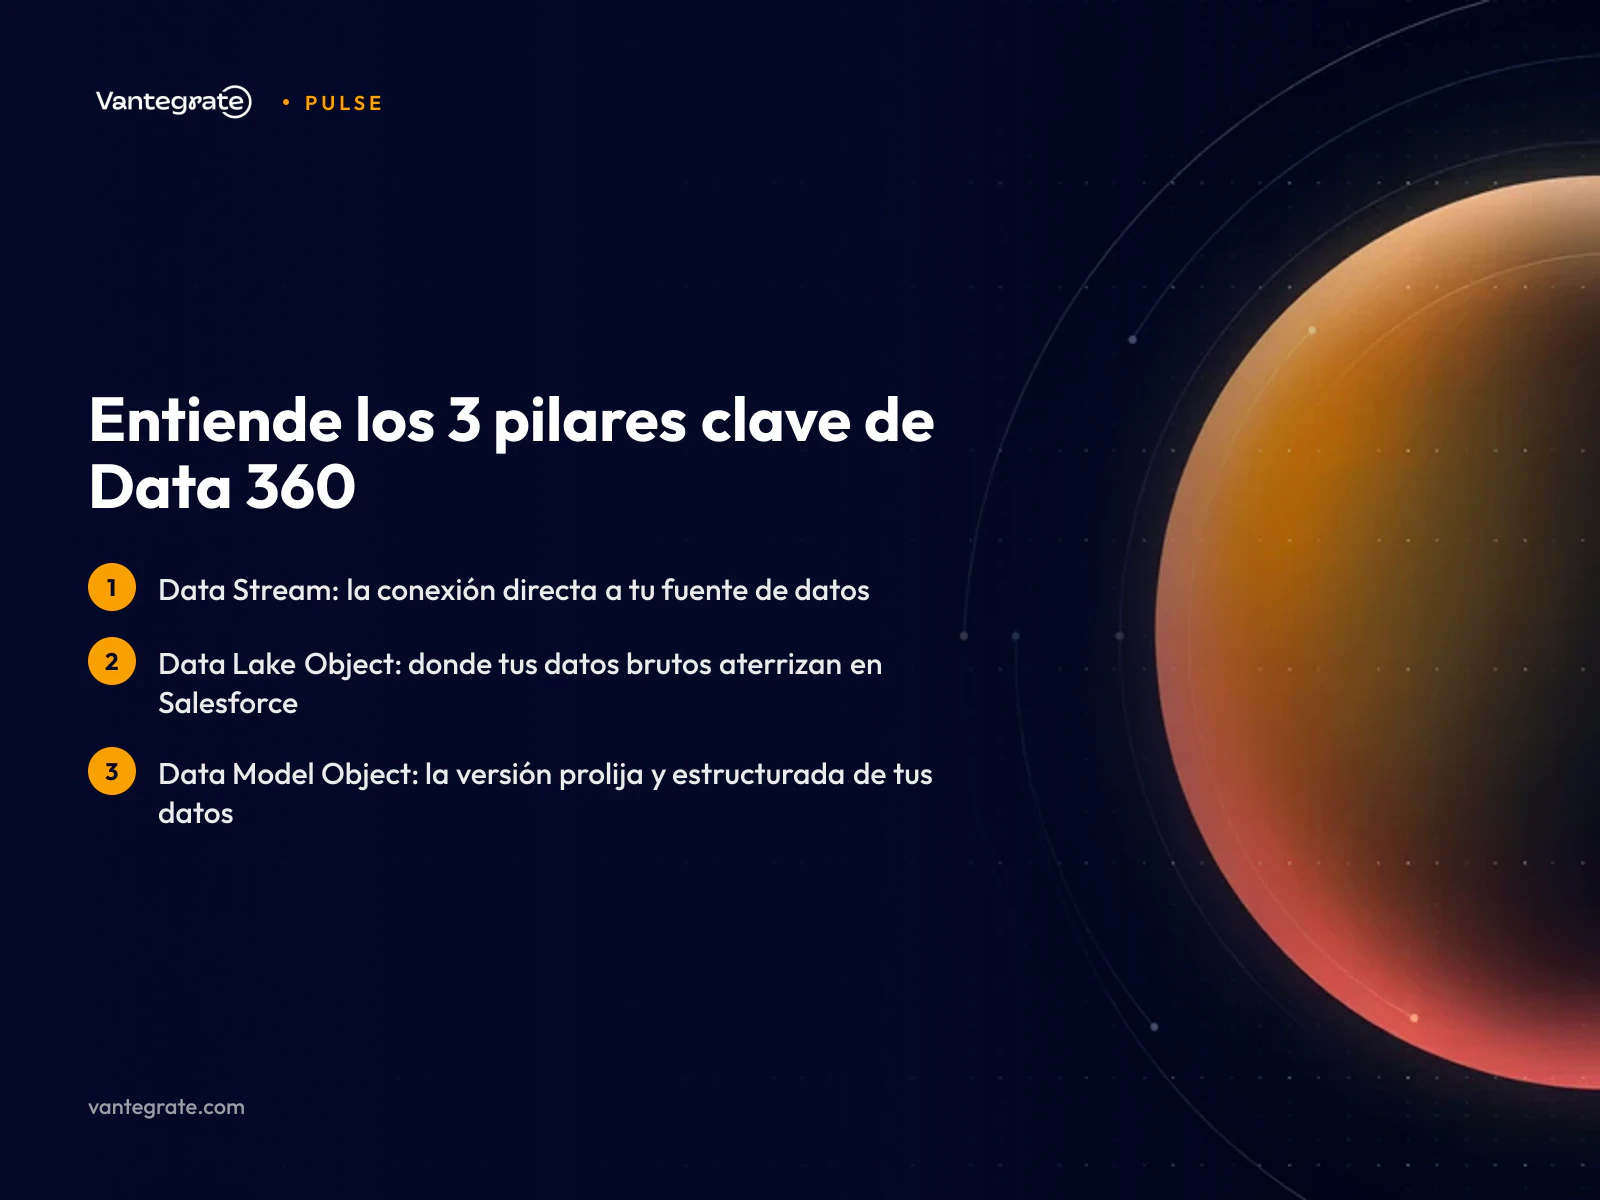
Comprender Data Stream, Data Lake Object y Data Model Object es fundamental para navegar Data Explorer y entender el flujo de tus datos.
Data Stream: la canilla hacia una fuente
Un Data Stream es la conexión con una fuente concreta. E-commerce, CRM, Snowflake, lo que sea.
Ahí vive la complejidad de integración. Frecuencia de refresh, historial, errores, cuántos registros entraron.
Esti mostró el home de Data 360 y abrió un stream. Primary key, mapeo de campos, preview: el puente entre el origen y el mundo Data 360.
Fran pidió volver un segundo al refresh. Pueden definir cada cuánto se actualiza y mirar el refresh history cuando algo se rompe.
Data Lake Object: la data cruda del lado Salesforce
El Data Lake Object (DLO) es donde aterriza la información cruda. El stream "chupa"; el lake object guarda (o representa) ese material sin el peinado canónico.
Salesforce crea varios DLO de fábrica. Ustedes pueden crear más (en la demo armaron piezas pensadas para que Agentforce se conecte).
Esti mostró campos y preview del lake. Es el material sin peinar: útil para entender qué llegó antes de forzar el modelo.
Data Model Object: el modelo prolijo
El Data Model Object (DMO) es lo que sacan del lake hacia un modelo fijado. Nombres, IDs, emails: la versión que el resto del stack entiende.
Esti lo resumió y Fran confirmó. Stream + Lake + Model son la clave para navegar Data Explorer sin marearse.
Si entienden esos tres, después entienden por qué falla un mapeo. Pegar palos sigue siendo parte del oficio; al menos saben dónde mirar.
En Data Explorer pueden inspeccionar lake o model. En la demo había contactos de prueba; el punto no era reinventar Contact, sino ver el camino Stream → Lake → Model.
Individual versus Contact (y por qué importa)
Un concepto filosófico que Esti marcó fuerte: el Individual no es lo mismo que el Contact del CRM.
El Individual intenta mapear a una persona física concreta. El Contact suele mapear datos de contacto de esa persona dentro de una empresa.
Si Esti cambia de compañía, el Contact se multiplica; la persona física es una. Data 360 unifica para saber quién es esa persona en todos los sistemas.
Eso es el corazón del CDP. No es solo "traer filas": es resolver identidad entre silos (correo acá, username allá, nombre y apellido en marketing).
Activaciones, segmentos y el ADN de Krux
JuanMa abrió el Setup de Data 360 al final. En plataformas de activación predeterminadas todavía se ve el génesis publicitario: Amazon Ads, Google Ads, LinkedIn, Meta, Pinterest, TikTok.
Eso no es casualidad. El producto nació cerca de campañas; su alcance se amplió, pero las activaciones hacia ads siguen ahí.
También mostró storage y conexiones externas. Google, Snowflake, sitios web: de nuevo, integrar, no pelearse a muerte con el lake que ya tienen.
Para desarrolladores de Salesforce, el tip fue doble. Miren el front de la app Data 360 y el Setup; no se queden solo con el brochure.
Los segmentos cierran el circuito comercial. Unifican, cortan audiencia y empujan a marketing, ads o un agente que escribe con contexto.
Agentforce, RAG y Einstein Studio: para qué "toma sentido"
Fran fue explícito con su opinión de producto. Antes de Agentforce le costaba ver tanta utilidad; linkeado con Agentforce, Data 360 encaja.
El upgrade clave que marcan es RAG (retrieval). Mucha información + búsqueda rápida para que el agente responda con contexto.
Esti mostró Einstein Studio (en la clase lo ligaron a Agentforce más que a "solo Data 360"). Ahí aparecen modelos sugeridos y, sobre todo, Retrievers.
El Retriever vectoriza y consulta Data Models (de la org y de Data 360). El circuito que describieron: Stream → Lake → Model → Retriever → Agentforce.
También hay Query Editor con SQL sobre DMO. No es SOQL de siempre; es query que después pueden atar a retrievers.
Data 360 dispara procesos. Triggers en Flow o Apex a partir de datos que viven afuera del Core, o widgets en el registro del cliente con últimas compras del e-commerce.
En Foundations, JuanMa marcó el checklist. Data 360, Foundation Features y Agentforce for Foundations tienen que figurar OK; si no, no avanzan.
Si quieren ver agentes en acción después de esta base, en agentes de IA y en una demo encuentran el hilo de producto de Vantegrate.
El mapa que se llevan de la clase
Fran organizó la masterclass en bloques a propósito. Historia de nombres, pricing y Agentforce, casos de uso, conceptos fundamentales y un pantallazo de configuración.
No pretendieron quemar dos horas en un solo wizard. Cuando se meten a configurar detalle por detalle, se va toda la clase; acá el objetivo fue que resuene el vocabulario.
Josu, Esti, Fran y JuanMa se repartieron teoría, demo y Setup. El tono fue el de siempre: mate, preguntas del chat y cero pose de brochure perfecto.
Si siguen el ciclo de los jueves, en Pulse y en recursos van a encontrar el resto del material. Data 360 desde cero es el mapa; el siguiente paso es practicar Stream, Lake y Model en una org con Foundations.